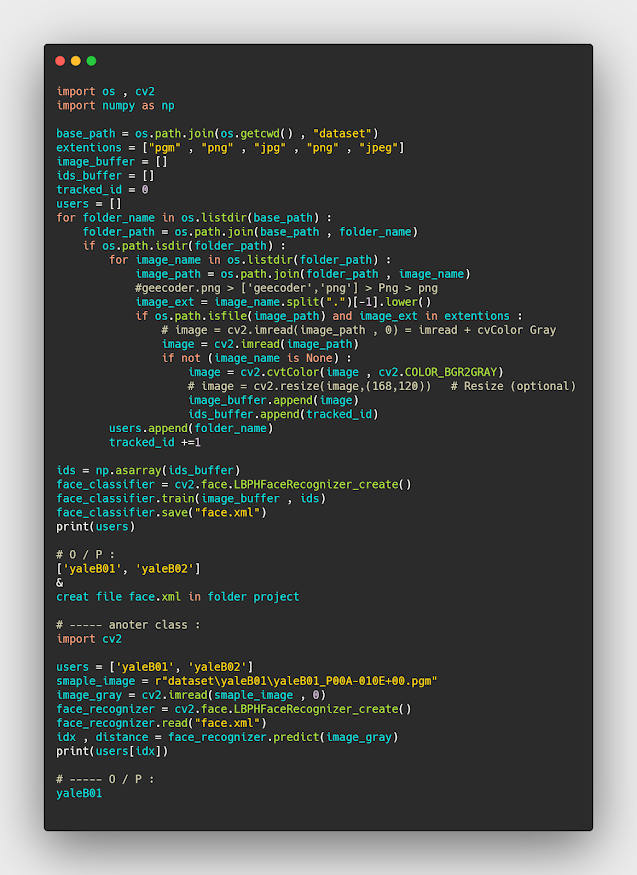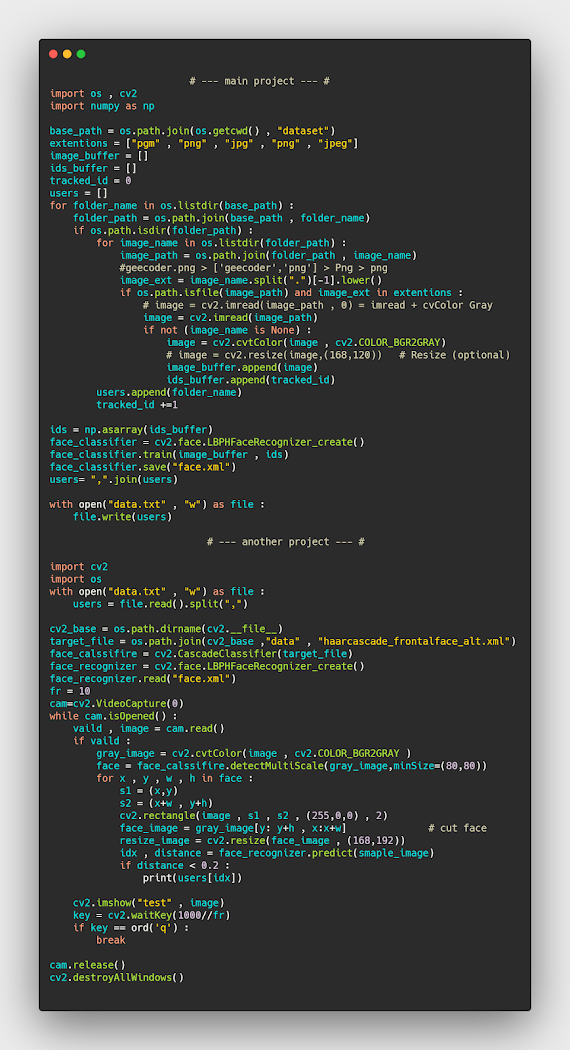


تدريب LBPH في Python يحتاج صورًا معنونة، ثم حفظ نموذج وخريطة تربط الأرقام بالأسماء. نستخدم مجلدًا لكل فئة، وصور وجوه مقصوصة ومتقاربة في الحجم داخله. المثال يقرأ الصور ويرتب المجلدات ثم يدرب النموذج ويكتب faces.yml وlabels.json. هذا تدريب محلي على الفئات التي وفرتها، وليس نظامًا يعرف الأشخاص دون بيانات سابقة. يمكن تجربة خط الأنابيب أولًا بصور أنماط صناعية لفهم الملفات بعيدًا عن بيانات حقيقية.
التجهيز والمتطلبات
python -m pip install "opencv-contrib-python>=4.10,<5" numpyهيكل البيانات وثبات التصنيفات
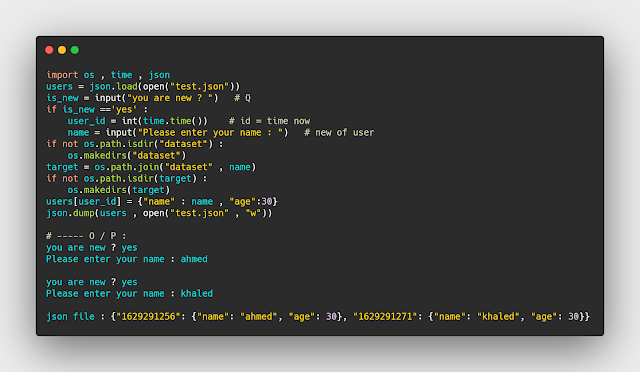
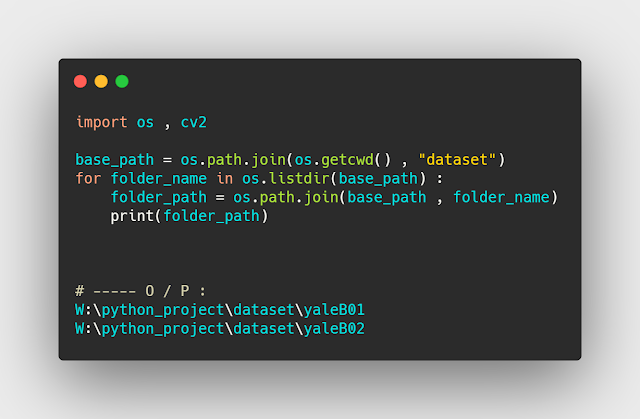
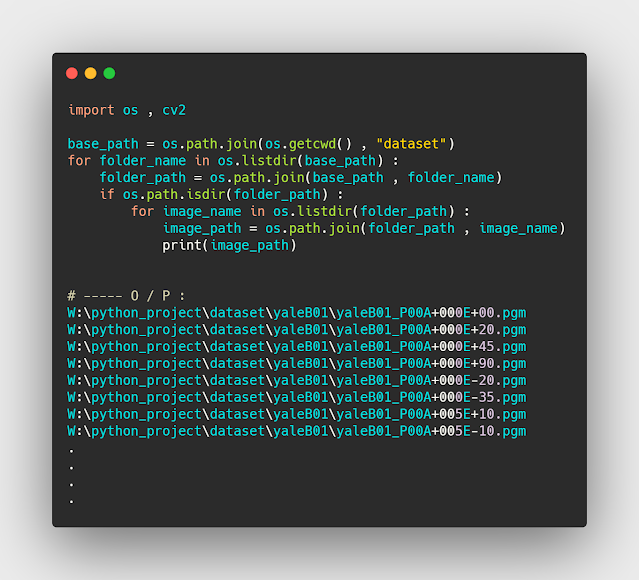
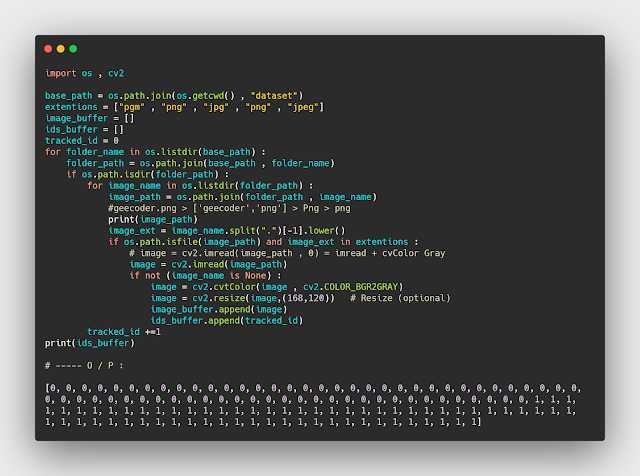
أنشئ dataset/person_a وdataset/person_b، وضع صور PNG أو JPEG المناسبة في كل مجلد. يقرأ البرنامج المسارات عبر pathlib بدل وصل النصوص يدويًا، ويرتبها لتكون النتائج مستقرة عند تكرار التدريب على البيانات نفسها. يفحص نتيجة imread وليس اسم الملف؛ وجود اسم لا يضمن أن الصورة قابلة للفك. يتجاوز الصور التالفة ويعطي رقمًا فقط للمجلد الذي يحتوي عينات فعلية. زيادة مجلدات أو إعادة تسميتها تستلزم استخدام خريطة التدريب الجديدة مع النموذج الجديد.
لماذا contrib ولماذا الصور الرمادية؟
الدالة cv2.face.LBPHFaceRecognizer_create تتطلب حزمة opencv-contrib-python. لا تجمعها مع opencv-python في البيئة نفسها، واستخدم إصدار OpenCV 4 الموافق للأمر. يحول المثال القراءة إلى الرمادي ويوحد المقاس إلى 100 في 100 قبل التدريب والتنبؤ. لا يقوم هذا الكود باكتشاف الوجه داخل صورة كبيرة؛ جهز القصاصات أولًا من درس اكتشاف الوجه. التدريب على خلفيات كاملة قد يتعلم اختلاف الخلفية بدل الملامح المطلوبة.
المثال البرمجي الكامل
from pathlib import Path
import json
import cv2
import numpy as np

def build_dataset(root):
    images, labels, names = [], [], {}
    folders = sorted(p for p in Path(root).iterdir() if p.is_dir())
    for folder in folders:
        samples = []
        for path in sorted(folder.iterdir()):
            if path.suffix.lower() not in {".png", ".jpg", ".jpeg"}:
                continue
            image = cv2.imread(str(path), cv2.IMREAD_GRAYSCALE)
            if image is not None:
                samples.append(cv2.resize(image, (100, 100)))
        if samples:
            label = len(names)
            names[label] = folder.name
            images.extend(samples)
            labels.extend([label] * len(samples))
    if not images:
        raise ValueError("No readable training images")
    return images, np.asarray(labels, dtype=np.int32), names

def train_dataset(root, model_path, labels_path):
    images, labels, names = build_dataset(root)
    model = cv2.face.LBPHFaceRecognizer_create()
    model.train(images, labels)
    model.write(str(model_path))
    Path(labels_path).write_text(json.dumps(names, ensure_ascii=False), encoding="utf-8")
    return model

def predict_crop(model_path, labels_path, crop_path):
    model = cv2.face.LBPHFaceRecognizer_create()
    model.read(str(model_path))
    names = json.loads(Path(labels_path).read_text(encoding="utf-8"))
    crop = cv2.imread(str(crop_path), cv2.IMREAD_GRAYSCALE)
    if crop is None:
        raise FileNotFoundError(crop_path)
    label, distance = model.predict(cv2.resize(crop, (100, 100)))
    return names.get(str(label), "unknown"), float(distance)

if __name__ == "__main__":
    # dataset/person_a/*.png and dataset/person_b/*.png contain cropped samples.
    train_dataset("dataset", "faces.yml", "labels.json")
    print(predict_crop("faces.yml", "labels.json", "test-crop.png"))
حفظ JSON دون إتلاف الملف
نكتب names مرة بعد بناء البيانات، ثم نقرأ labels.json بواسطة read_text عند التنبؤ. فتح الملف بالنمط w قبل قراءته يمحو محتواه، لذا نفصل القراءة عن الكتابة. تتحول مفاتيح القاموس العددية إلى نصوص في JSON، ولذلك نستخدم str(label) عند البحث. يحتفظ النموذج وخريطة الأسماء بعلاقة واحدة؛ نقل faces.yml وحده دون الملف المطابق قد يؤدي إلى عرض اسم خاطئ رغم نجاح التحميل.
التنبؤ وتفسير المسافة
تستقبل predict مصفوفة الصورة بعد تحويلها، وليس نص مسار ملف. تعيد رقم الفئة ومسافة؛ هذه ليست احتمالًا محصورًا بين صفر وواحد. المثال يعرض أقرب فئة في التدريب فقط، ولا يضع عتبة مدروسة لرفض شخص غير معروف. احفظ الملف باسم lbph_dataset.py وجهز test-crop.png ثم شغله في مجلد تجربة، لأن ملفات النموذج والربط ستستبدل عند إعادة التدريب. افصل عينات التقييم عن التدريب واضبط الرفض قبل أي استخدام حقيقي.
لماذا لا نقيس الدقة على صورة التدريب نفسها؟
حصول النموذج على الفئة الصحيحة عند تمرير صورة سبق تدريبها يثبت أن مسار التدريب والحفظ والتحميل يعمل، لكنه لا يقيس التعميم. خصص صور تقييم مختلفة والتقطها في ظروف متنوعة، ولا تجعل نسخًا شبه متطابقة من الإطار نفسه موزعة بين التدريب والتقييم. سجل عدد العينات لكل فئة ونوعية الأخطاء، ثم افحص هل يتأثر القرار بالخلفية أو الإضاءة أكثر من الهدف المقصود. المقارنة المنصفة تحتاج تقسيمًا واضحًا للبيانات.
كيف أرفض فئة غير معروفة؟
المثال يعيد أقرب فئة فقط، وهو سلوك يجب توضيحه في الواجهة. لرفض مدخل غير معروف تحتاج اختيار عتبة مسافة بناءً على بيانات تحقق، ثم عرض unknown عندما تتجاوز النتيجة الحد. لا تنقل عتبة من نموذج آخر أو تعتبر المسافة نسبة احتمال. احفظ العتبة وإعدادات تجهيز الصورة مع إصدار النموذج، وأعد التقييم عند إضافة فئة أو تغيير مقاس القصاصات. وجود اسم في JSON لا يجعله قرارًا مؤكدًا.
المراجع
الصور والفيديو من الشرح السابق
الكود النصي أعلاه هو النسخة المصححة؛ قد تختلف المواد المرئية السابقة في أسماء المتغيرات أو طريقة التشغيل.