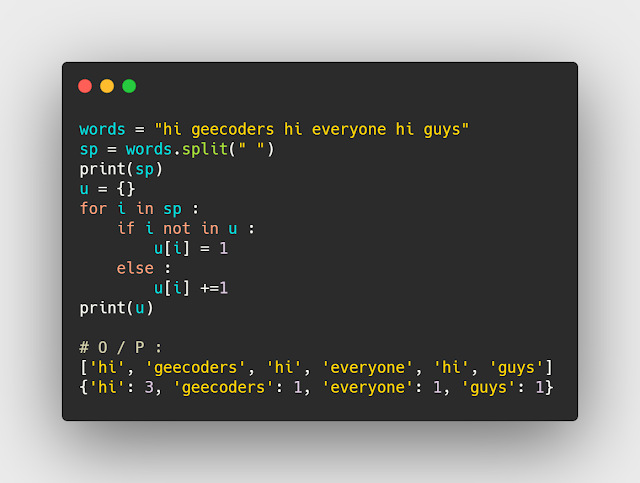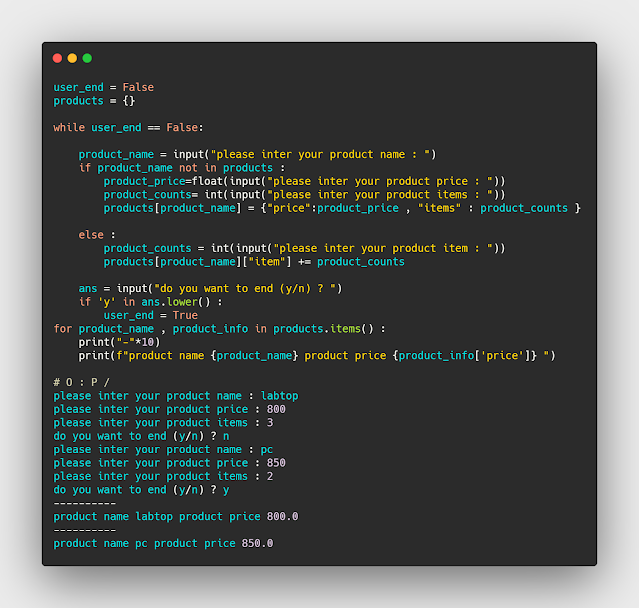


عد تكرار الكلمات في Python يختلف عن عد ظهور سلسلة داخل نص. الكلمة gee قد تظهر داخل geecoders، لكن ذلك لا يجعلها كلمة مستقلة ثانية. سنقسم النص إلى وحدات ثم نحصيها، ونطبق فكرة التجميع على قاموس كتب وأصحاب. يحتاج كل مشروع تحديد ما يعد كلمة وكيف يعالج حالة الحروف والترقيم، لذلك نوضح القاعدة المستخدمة بدل الادعاء أن كل اللغات والنصوص تتبع التقسيم نفسه.
التجهيز والتشغيل
استخدم Python 3.9 أو أحدث واحفظ المثال في ملف مستقل خارج مجلد مكتبات Python.
python lesson_25591.pyالتقسيم والتوحيد قبل العد
نستخدم casefold لتوحيد حالة الحروف حيث تنطبق، ثم التعبير \w+ لاستخراج تسلسلات الحروف والأرقام والشرطة السفلية وفق Unicode. يسمح ذلك بوجود كلمات عربية دون قائمة حروف لاتينية فقط. لكنه لا يزيل التشكيل أو يوحد أشكال الألف تلقائيًا، وقد يعد الرقم أو النص الذي يحتوي underscore وحدة مستقلة. إذا كانت هذه القواعد لا تناسب بياناتك فعدل مرحلة التقسيم واختبرها قبل تغيير خوارزمية العد.
Counter أو قاموس يدوي
تستقبل Counter تسلسل الكلمات وتجمع عدد كل قيمة، ثم نحولها إلى dict لعرض النتيجة بشكل مألوف. ويمكن تنفيذ الفكرة يدويًا عبر counts[word] = counts.get(word, 0) + 1. لا تستعمل text.count(word) داخل حلقة الكلمات وتظن أنك تعد الكلمات الكاملة؛ هذا يعد أجزاء نصية ويعيد فحص النص مرارًا. افصل تحويل النص إلى كلمات عن عد القيم كي تختبر كل خطوة وتفهم مصدر أي اختلاف.
المثال البرمجي الكامل
from collections import Counter
from time import perf_counter
import re

def word_counts(text):
    words = re.findall(r"\w+", text.casefold(), flags=re.UNICODE)
    return dict(Counter(words))

def group_by_owner(books):
    grouped = {}
    for title, owner in books.items():
        grouped.setdefault(owner, []).append(title)
    return grouped

if __name__ == "__main__":
    start = perf_counter()
    counts = word_counts("gee geecoders gee! مرحبا، مرحبا")
    elapsed = perf_counter() - start
    print(counts)
    print("Elapsed seconds:", elapsed)
    print(group_by_owner({"Python": "Ali", "SQL": "Mona", "Web": "Ali"}))
تجميع القاموس بحسب صاحب الكتاب
يربط قاموس الإدخال عنوان الكتاب باسم صاحبه. تعيد group_by_owner قاموسًا جديدًا يربط كل صاحب بقائمة عناوينه. تستخدم setdefault لإنشاء قائمة أول مرة ثم تضيف العنوان. لا نستبدل القائمة بعنوان واحد عند ظهور المالك نفسه لاحقًا، ولا نفترض أن صاحبًا بعينه موجود في كل بيانات؛ عند الاستعلام يمكن استعمال get مع قائمة افتراضية. هذه عملية تجميع عدة قيم تحت مفتاح واحد وليست قلبًا بسيطًا للمفاتيح والقيم.
الزمن المنقضي يجب أن يكون النهاية ناقص البداية
نستخدم perf_counter للمدة ونحسب elapsed بعد انتهاء الدالة ناقص وقت البداية. عكس الطرح قد يعرض مدة سالبة رغم نجاح العملية. قياس تجربة صغيرة واحدة يتأثر بأعمال الجهاز ودقة القياس، فلا يثبت أن أسلوبًا أسرع دائمًا. إذا أردت المقارنة استخدم نصًا معلومًا وكرر التجربة وراجع نتائج العد نفسها، لأن تنفيذًا سريعًا يعطي عدًا مختلفًا لا يحل المسألة المطلوبة.
نتائج التشغيل والبيانات الفارغة
يعطي النص التجريبي gee مرتين وgeecoders مرة ومرحبا مرتين، بعد التخلص من علامات الترقيم المحيطة. النص الفارغ يعيد قاموسًا فارغًا دون تقسيم خاص. ويجمع المثال كتابي Python وWeb تحت Ali ويترك SQL تحت Mona. جرب كلمة في آخر النص دون فراغ بعدها، لأن بعض الحلقات اليدوية تنسى إضافة الكلمة الأخيرة بعد انتهاء المرور على الحروف.
الترتيب والعرض لا يغيران معنى التكرار
قد تحتاج عرض الأكثر تكرارًا أولًا، ويمكن استخدام Counter.most_common أو ترتيب عناصر القاموس بعد تحديد سياسة التعادل. لا تغير قيمة التكرار لمجرد ترتيب العرض، ولا تعتمد على رقم موضع الكلمة في القاموس باعتباره عدد مرات ظهورها. وإذا أردت مقارنة نصين فاستعمل قواعد تقسيم وتوحيد واحدة لكليهما، وإلا قد تنسب اختلافًا ناتجًا عن التنظيف إلى المحتوى نفسه.
تمارين توسع المثال
اختبر gee وgeecoders في الجملة نفسها، ثم حالة حروف مختلفة وعلامة ترقيم متصلة وكلمة عربية مشكلة. حدد هل تريد دمج بعض هذه الحالات واكتب الناتج المتوقع قبل تعديل التعبير. وفي التجميع أضف مالكًا بلا كتب في سياسة عرض منفصلة، ولا تضفه ضمن البيانات إن لم يكن له عنوان. يمكن لاحقًا قراءة النص أو بيانات الكتب من ملف JSON، مع إبقاء الدوال الحالية مستقلة عن مسارات الملفات وواجهات المستخدم.
المراجع
الصور والفيديو من الشرح السابق
الكود النصي أعلاه هو النسخة المصححة؛ قد تختلف المواد المرئية السابقة في أسماء المتغيرات أو طريقة التشغيل.