

تجمع GROUP BY في Oracle صفوفًا لها قيمة تصنيف واحدة كي نحسب لكل مجموعة عددًا أو متوسطًا. تطبق WHERE على الصفوف قبل التجميع، بينما تفحص HAVING نتيجة المجموعة بعد حساب الدوال التجميعية.
تستخدم الأمثلة جداول التدريب في درس إنشاء جداول وبيانات تدريب Oracle. نفّذ إعدادها مرة واحدة في مخطط تدريب قبل الاستعلامات، حتى تتطابق أسماء الأعمدة والنتائج.
مثال SQL قابل للنسخ
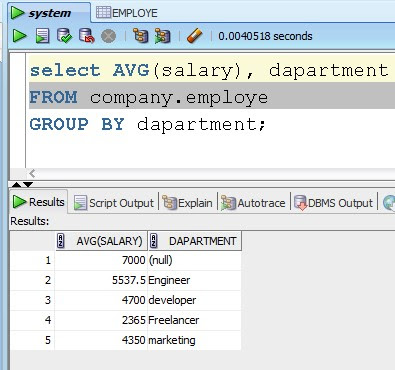
SELECT dept_id, COUNT(*) AS employee_count, AVG(salary) AS avg_salary
FROM gc_employees
GROUP BY dept_id
ORDER BY dept_id NULLS LAST;

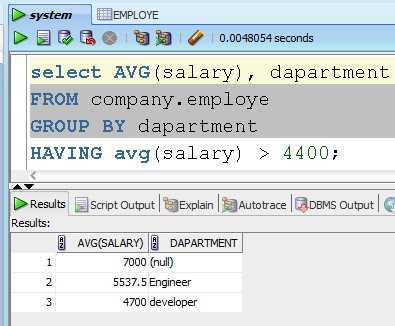
SELECT dept_id, AVG(salary) AS avg_salary
FROM gc_employees
WHERE salary IS NOT NULL
GROUP BY dept_id
HAVING AVG(salary) > 5000
ORDER BY dept_id NULLS LAST;
فهم النتائج
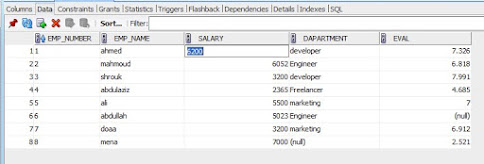
في المثال الأول متوسط القسم 10 هو 6000، والقسم 20 هو 4500، والقسم 30 هو 6000. توجد مجموعة للموظفين ذوي dept_id المجهول، وعددهم 2 لكن المتوسط 3000 لأن AVG تتجاهل الراتب NULL. لا يفترض البرنامج أن عدد الرواتب المعروفة يساوي عدد الموظفين.
التصفية قبل التجميع وبعده
يستبعد المثال الثاني الرواتب غير المعروفة أولًا، ثم يعرض الأقسام التي يتجاوز متوسطها 5000، فتظهر 10 و30. إذا أردت مجموعًا يتجاوز حدًا معينًا فاكتب HAVING SUM(salary) مع وصف مطابق؛ لا تصف SUM في النص ثم تنفذ AVG في الكود.
منع ORA-00979
عند استخدام التجميع يجب أن يكون العمود المعروض غير المجمع ضمن GROUP BY وفق صياغة أمثلة Oracle 19c/21c هنا. لا تضف emp_name عشوائيًا إلى SELECT وتتوقع أن يختار Oracle اسمًا يمثل القسم. لتفاصيل الموظفين مع متوسط قسمهم يمكن تعلم الدوال التحليلية في درس منفصل.
الصور والفيديو من الشرح السابق
الكود النصي أعلاه هو النسخة المصححة؛ قد تختلف المواد المرئية السابقة في أسماء المتغيرات أو طريقة التشغيل.